
Исследование ETH Zurich и Anthropic показало, что студенты магистратуры могут раскрывать личности анонимных пользователей всего за несколько долларов
Исследователи из $ETH Zurich, группы MATS по безопасности ИИ и Anthropic разработали автоматизированный конвейер LLM, способный связывать анонимные сообщения с реальными личностямиdentОн смог идентифицироватьdentпользователей Hacker News с точностью до 90% всего за 1 доллар за пользователя.
Февральский номер газеты на этой неделе снова появился на платформах X и Reddit.
Статья «Масштабная онлайн-деанонимизация с использованием LLM» была впервые опубликована на arXiv 18 февраля. Позже она появилась в материалах 35-го симпозиума USENIX по безопасности.
Авторами являются Саймон Лермен, Даниэль Палека, Джошуа Свансон, Майкл Аэрни, Николас Карлини и Флориан Трамер. Карлини — сотрудник компании Anthropic, создателя Claude, а остальные — сотрудники $ETH Zurich и MATS.
В четыре этапа из 89 000 кандидатов отбирается короткий список
Никаких украденных данных или взломанных серверов замешано не было. Агент читает информацию, которую и так может увидеть любой, а затем выполняет работу терпеливого следователя, но дешевле и быстрее.
Исследователи разделили атаку на четыре этапа, которые они назвали «trac», «Поиск», «Рассуждение» и «Калибровка». На первом этапе языковая модель получаетdentоб идентичности из исходных сообщений, такие как намек на профессию, местоположение или способ выражения.
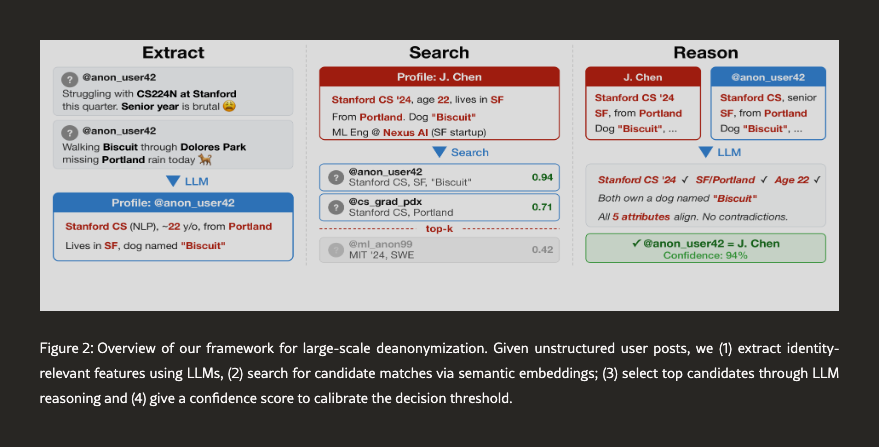
На рисунке 2 статьи показаны этапы извлеченияtracпоиска и обоснования, выполненные на основе иллюстративного вымышленного профиля.
Затем семантические векторные представления сужают круг кандидатов, насчитывающий до 89 000 человек, до короткого списка. Модель логического мышления оценивает наиболее подходящие совпадения и определяет, принадлежат ли две учетные записи одному и тому же человеку.
Этап калибровки приводит к тому, что конвейер останавливается, если нет полной уверенности. Меньше ложных срабатываний.
Конвейер обработки данных работает на основе готовых инструментов, веб-поиска, эмбеддингов и моделей, например, GPT-5.2. Предыдущие атаки по деанонимизации, такие как повторнаяdentанонимизированных рейтингов Netflix в 2008 году, основывались на структурированных данных.
Разработанный алгоритмdent226 из 338 пользователей Hacker News с точностью до 90%
Чтобы оценить метод, не рискуя реальными людьми, команда собрала 338 пользователей Hacker News, в биографиях которых были ссылки на страницы LinkedIn. У каждого из них была известная достоверная информация оdent.
Получив только комментарии и заявки, агент правильно позвонил по 226 номерам, примерно в 67% случаев с точностью 90%. Агент допустил 25 ошибок и передал 86 клиентам.
Classicбазовые модели, не использующие LLM, показали результаты, близкие к нулю, в более масштабных тестах сопоставления, описанных в статье. Эксперименты обошлись менее чем в 2000 долларов, или от 1 до 4 долларов за профиль.
Два других набора данных сопоставили пользователей Reddit из двух разных киносообществ и восстановили историю Reddit, разделив её на два временных периода. И в каждом случае методы LLM значительно превзошли старые методы.
Авторы приводят в пример преследования журналистов и активистов со стороны правительств, компании, создающие все более точные рекламные профили, и мошенников, собирающих досье для проведения мошеннических схем с использованием методов социальной инженерии.
«Часто это уникальный набор отпечатков пальцев», — написал Лермен в своем блоге 24 февраля. Он добавил, что если команда умных следователей смоглаdentчеловека по его сообщениям, то агенты , вероятно, тоже смогут это сделать, и стоимость этой услуги будет только снижаться.
Исследователи не опубликовали код, подсказки или какие-либо реальныеdent, обнаруженные системой. Перед публикацией исследование было рассмотрено этическим комитетом $ETH Zurich.
В заключение статьи говорится, что «практическая непрозрачность, защищающая анонимных пользователей в интернете, больше не сохраняется»
Всплеск интереса к этой статье произошел на следующий день после того, как комиссар SEC Хестер Пирс предостерегла от массового сбора данных в рамках процедуры KYC (Know Your Customer — «Знай своего клиента»). Пирс заявила, что такой подход равносилен «накоплению все больших и больших стогов данных».
Недавние утечки данных в Revolut и у поставщиков, связанных с производителем аппаратных кошельков Trezor, усилили опасения по поводу так называемых «атак с использованием ключа», когда кто-то, узнавший, кто владеет криптовалютой, лично появляется на рабочем месте.

 Bitcoin
 Ethereum
 Tether
 USDC
 TRON
 Zcash
 Dogecoin
 Chainlink
 Monero
 Cardano
 LEO Token
 Stellar
 Bitcoin Cash
 Litecoin
 Dai
 Hedera
 Cronos
 OKB
 Ethereum Classic
 Algorand
 KuCoin
 Cosmos Hub
 Dash
 VeChain
 TrueUSD
 Tezos
 Decred
 IOTA
 NEO
 Basic Attention
 Qtum
 0x Protocol
 Lisk
 Ontology
 Ravencoin
 Waves
 Pax Dollar
 Huobi
 ICON
 Bitcoin Diamond
 MonaCoin